【数学建模笔记】数学建模的回归分析

回归分析是对拟合问题作统计分析,包括模型建立、可信度检验、预测和控制。

回归分析的主要步骤是:

  1. 由观测值确定参数 (回归系数) 的估计值;
  2. 对线性关系、自变量的显著性进行统计检验;
  3. 利用回归方程进行预测。

多元线性回归分析

参数估计

对于 元线性回归模型 对 作 次抽样得到 组数据 ,

记

于是模型可以表示为 选取估计值 ,使当 时,误差平方和 最小,为此,令 得 可以化为 有解 将 代入得 于是有残差平方和

系数检验

总平方和 其中 称回归平方和。

为检验 ​ 和变量 ​ 是否都有线性关系,假定 与 的线性关系都不显著,则所有的 都很小。

因此,令原假设为 经数学证明,当 成立时,满足 对显著性水平 ,若 ,回归方程效果显著;反之不显著。

当 被拒绝时, 不全为 0,但是不排除其中若干个为 0,应进一步作检验,分别令原假设为 当 为真时,有 其中 是 中的第 个元素。

对于 ,若 , 显著;否则,去掉变量 重新建立回归方程。

还有其他衡量相关成都的指标如 ​ 称复相关系数,​ 越大,相关关系或密切,通常 或​ 才认为相关。

回归预测

对于给定 ,代入得 作为 的预测值。

也可以进行区间估计,记 ,,则 置信度为 的预测区间为

较大时有:

  • 95% 预测区间 ;
  • 98% 预测区间 。

线性回归模型正则化

对于多元线性回归,当 ​ 不是满秩矩阵时存在多个解,常见做法是引入正则化项,通常有岭回归和 LASSO 回归两种方法。

岭回归

如果 个变量间存在较强相关性 (共线性),会导致 ,从而引起 ​ 对角线的值很大,导致 ​ 变化非常大。

因此引入惩罚函数 ,使得 尽量小,从而减少共线性的影响,构造新的目标函数 于是有 对 的选用可以采用:

  • 岭迹法:选取使 稳定的最小 值;
  • 均方误差法:选取使岭估计均方误差的最小 ​ 值。

LASSO 回归

与岭回归不同,LASSO 回归的惩罚项是 ​,从而有目标函数 于是有

Logistic 回归

对于多元线性回归模型 可以使用阶跃函数转化为分类模型 然而阶跃函数不连续、不可导,于是代入 Sigmoid 函数 于是有

故

参数估计

Logistic 回归由于涉及概率运算,不便用最小二乘法估计参数,因此另辟蹊径,使用最大似然估计法。

对于上面两式,由于 只取 0 或 1,可以概括为

得似然函数

为求解方便,取对数得 可以使用梯度下降法上式求最大值,从而得到参数。

Python 代码

多元线性回归分析

对于下例

x1 x2 y
7 26 78.5
1 29 74.3
11 56 104.3
11 31 87.6
7 52 95.9
11 55 109.2
3 71 102.7

求线性回归模型 的估计值。

sklearn

使用 sklearn 求解,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# %%

import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression

# %%

df = pd.DataFrame({
'x1': [7, 1, 11, 11, 7, 11, 3],
'x2': [26, 29, 56, 31, 52, 55, 71],
'y': [78.5, 74.3, 104.3, 87.6, 95.9, 109.2, 102.7],
})

X = np.array(df[['x1','x2']])
y = np.array(df[['y']])
model = LinearRegression().fit(X, y)

# %%

b0 = model.intercept_[0]
b1, b2 = model.coef_[0]
print('y = {:.4f} + {:.4f}*x1 + {:.4f}*x2'.format(b0, b1,b2))
print('R_square =',model.score(X,y))

输出如下:

1
2
y = 51.5697 + 1.4974*x1 + 0.6723*x2
R_square = 0.9744954805639265

statsmodels

使用 statsmodels 求解,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
#! /usr/bin/env python
# -*- coding: utf-8 -*-
# @ author: Koorye
# @ date: 2021-7-26
# @ function: 使用 statsmodels 进行多元线性回归

# %%

import numpy as np
import pandas as pd
from statsmodels.formula.api import ols

# %%

dic = {
'x1': [7, 1, 11, 11, 7, 11, 3],
'x2': [26, 29, 56, 31, 52, 55, 71],
'y': [78.5, 74.3, 104.3, 87.6, 95.9, 109.2, 102.7],
}
model = ols('y~x1+x2', dic).fit()

# %%

model.summary()

输出如下:

Dep. Variable: y R-squared: 0.974
Model: OLS Adj. R-squared: 0.962
Method: Least Squares F-statistic: 76.42
Date: Mon, 26 Jul 2021 Prob (F-statistic): 0.000650
Time: 21:19:31 Log-Likelihood: -14.732
No. Observations: 7 AIC: 35.46
Df Residuals: 4 BIC: 35.30
Df Model: 2
Covariance Type: nonrobust
coef std err t P>|t| [0.025 0.975]
Intercept 51.5697 3.523 14.640 0.000 41.789 61.350
x1 1.4974 0.264 5.681 0.005 0.766 2.229
x2 0.6723 0.063 10.717 0.000 0.498 0.847
Omnibus: nan Durbin-Watson: 2.660
Prob(Omnibus): nan Jarque-Bera (JB): 1.891
Skew: 1.273 Prob(JB): 0.388
Kurtosis: 2.992 Cond. No. 174.

Notes: [1] Standard Errors assume that the covariance matrix of the errors is correctly specified.

两者结果相同,,不过 statsmodels 输出了非常详细的报告。

岭回归

对上例进行岭回归,并选择合适的 值,使用 sklearn 求解,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
#! /usr/bin/env python
# -*- coding: utf-8 -*-
# @ author: Koorye
# @ date: 2021-7-26
# @ function: 使用 sklearn 进行岭回归

# %%

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import Ridge, RidgeCV

# %%

# 源数据
df = pd.DataFrame({
'x1': [7, 1, 11, 11, 7, 11, 3],
'x2': [26, 29, 56, 31, 52, 55, 71],
'y': [78.5, 74.3, 104.3, 87.6, 95.9, 109.2, 102.7],
})

X = np.array(df[['x1', 'x2']])
y = np.array(df[['y']])

# 遍历 k,计算不同 k 时的拟合结果
k_array = np.logspace(-4, 1.5, 100)
x1_list, x2_list = [], []
for k in k_array:
model = Ridge(alpha=k).fit(X, y)
x1_list.append(model.coef_[0][0])
x2_list.append(model.coef_[0][1])

# %%

# 作岭迹图
plt.scatter(k_array,x1_list)
plt.scatter(k_array,x2_list)
plt.plot(k_array, x1_list, label='x1')
plt.plot(k_array, x2_list, label='x2')
plt.legend()

# %%

# 自动匹配最佳 k 值
model2 = RidgeCV().fit(X, y)

# %%

# 截距
b0 = model2.intercept_[0]

# 系数
b1, b2 = model2.coef_[0][0], model2.coef_[0][1]

print('y = {:.4f} + {:.4f}*x1 + {:.4f}*x2'.format(b0, b1, b2))
print('R_square =', model2.score(X, y))
print('k =', model2.alpha_)

输出如下:

1
2
3
y = 52.6722 + 1.3610*x1 + 0.6700*x2
R_square = 0.9727637007583043
k = 10.0

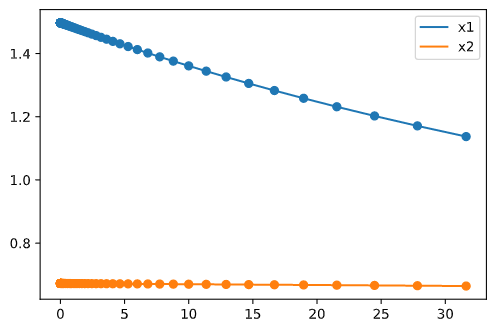
上图为 取不同值时的 的系数 的变化,可以看到该问中系数的变化是相对稳定的,没有明显的拐点,这说明变量间不存在显著的共线性。

使用 sklearn 自动匹配最佳 值,结果为 ,并有 ,此时 。

LASSO 回归

同样进行 LASSO 回归,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
#! /usr/bin/env python
# -*- coding: utf-8 -*-
# @ author: Koorye
# @ date: 2021-7-26
# @ function: 使用 sklearn 进行 lASSO 回归

# %%

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import Lasso, LassoCV

# %%

# 源数据
df = pd.DataFrame({
'x1': [7, 1, 11, 11, 7, 11, 3],
'x2': [26, 29, 56, 31, 52, 55, 71],
'y': [78.5, 74.3, 104.3, 87.6, 95.9, 109.2, 102.7],
})

X = np.array(df[['x1', 'x2']])
y = np.array(df[['y']])

# 遍历 k,计算不同 k 时的拟合结果
k_array = np.logspace(-4, 1.5, 100)
x1_list, x2_list = [], []
for k in k_array:
model = Lasso(alpha=k).fit(X, y)
x1_list.append(model.coef_[0])
x2_list.append(model.coef_[1])

# %%

# 作岭迹图
plt.scatter(k_array,x1_list)
plt.scatter(k_array,x2_list)
plt.plot(k_array, x1_list, label='x1')
plt.plot(k_array, x2_list, label='x2')
plt.legend()

# %%

# 自动匹配最佳 k 值
model2 = LassoCV().fit(X, y)

# %%

# 截距
b0 = model2.intercept_

# 系数
b1, b2 = model2.coef_[0], model2.coef_[1]

print('y = {:.4f} + {:.4f}*x1 + {:.4f}*x2'.format(b0, b1, b2))
print('R_square =', model2.score(X, y))
print('k =', model2.alpha_)

输出如下:

1
2
3
y = 52.7036 + 1.3770*x1 + 0.6667*x2
R_square = 0.973087311206934
k = 1.7257551020408168

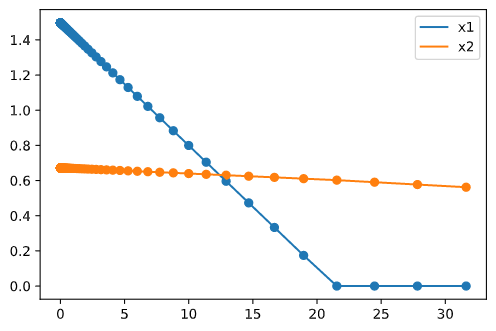
与岭回归不同的是,LASSO 回归系数变化是平直且突变的。

Logistic 回归

对下例

甜度 密度 体积 质量 是否为好瓜
0.95 0.876 1.85 2.51 是
0.76 0.978 2.14 2.45 是
0.82 0.691 1.34 1.34 否
0.57 0.745 1.38 1.15 否
0.69 0.512 0.67 1.23 否
0.77 0.856 2.35 3.95 是
0.89 1.297 1.69 2.67 是

进行 Logistic 回归分析,并进行预测。

sklearn

使用 sklearn 实现,代码如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
#! /usr/bin/env python
# -*- coding: utf-8 -*-
# @ author: Koorye
# @ date: 2021-7-26
# @ function: 使用 sklearn 进行岭回归

# %%

import numpy as np
import pandas as pd
from sklearn.linear_model import LogisticRegression

# %%

# 源数据
df = pd.DataFrame({
'good': [1, 1, 0, 0, 0, 1, 1],
'sweet': [.95, .76, .82, .57, .69, .77, .89],
'density': [.876, .978, .691, .745, .512, .856, 1.297],
'volume': [1.85, 2.14, 1.34, 1.38, 0.67, 2.35, 1.69],
'quality': [2.51, 2.45, 1.34, 1.15, 1.23, 3.95, 2.67],
})

# 样本集
X = np.array(df[df.columns[1:]])

# 标签集
y = np.array(df['good'])

# 建立模型
model = LogisticRegression()
model.fit(X, y)

# %%

# 截距
b0 = model.intercept_[0]

# 系数
b1, b2, b3, b4 = model.coef_[0][0], model.coef_[0][1], \
model.coef_[0][2], model.coef_[0][3]

b0, b1, b2, b3, b4

# %%

df2 = pd.DataFrame({
'sweet': [.5, 1],
'density': [.5, 1],
'volume': [.5, 2],
'quality': [.5, 2],
})
model.predict(np.array(df2))

输出如下:

1
2
3
4
5
6
7
8
9

# 截距...
(-3.370933696851626,
0.13186817837303025,
0.29709467699778236,
0.6067592080789701,
1.1302193116167027)

array([0, 1], dtype=int64)

前 5 个值代表系数 。​

后 2 个值代表对两个样本的预测。第一个样本甜度、密度、体积、质量全为 0.5;第二个样本甜度、密度为 1,体积、质量为 2。预测结果为:

  • 第一个样本:不是好瓜;
  • 第二个样本:是好瓜。

可以代入验算,对于 当 时,

当 时,,不是好瓜的可能性更大。

当 ​ 时,​,是好瓜的可能性更大。

statsmodels

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
#! /usr/bin/env python
# -*- coding: utf-8 -*-
# @ author: Koorye
# @ date: 2021-7-26
# @ function: 使用 sklearn 进行岭回归

# %%

import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

# %%

# 源数据
df = pd.DataFrame({
'good': [1, 1, 0, 0, 0, 1, 1],
'sweet': [.95, .76, .82, .57, .69, .77, .89],
'density': [.876, .978, .691, .745, .512, .856, 1.297],
'volume': [1.85, 2.14, 1.34, 1.38, 0.67, 2.35, 1.69],
'quality': [2.51, 2.45, 1.34, 1.15, 1.23, 3.95, 2.67],
})

# 建立模型
model = smf.logit('good~sweet+density+volume+quality', df)

# %%

res = model.fit(method='bfgs')
res.summary()

# %%

df2 = pd.DataFrame({
'good': [None, None],
'sweet': [.5, 1],
'density': [.5, 1],
'volume': [.5, 2],
'quality': [.5, 2],
})
res.predict(df2)

输出结果为:

Dep. Variable: good No. Observations: 7
Model: Logit Df Residuals: 2
Method: MLE Df Model: 4
Date: Mon, 26 Jul 2021 Pseudo R-squ.: 1.000
Time: 22:56:51 Log-Likelihood: -2.8779e-05
converged: True LL-Null: -4.7804
Covariance Type: nonrobust LLR p-value: 0.04852
coef std err z P>|z| [0.025 0.975]
Intercept -28.6968 2005.820 -0.014 0.989 -3960.032 3902.639
sweet -13.9757 2808.332 -0.005 0.996 -5518.206 5490.254
density -4.8468 2477.251 -0.002 0.998 -4860.170 4850.476
volume -0.5361 1024.433 -0.001 1.000 -2008.387 2007.315
quality 23.2646 1230.217 0.019 0.985 -2387.917 2434.446
1
2
3
0    2.428405e-12
1 1.128262e-01
dtype: float64

有 ​,预测结果为 ​,不是好瓜的概率都很大。

注意到 statsmodels 的结果与 sklearn 不同,原因是采用了不同的求解方法。

作者

Koorye

发布于

2021-07-26

更新于

2025-12-08

许可协议